RAG: Cara Membuat Asisten AI Menjawab dari Ratusan Gigabyte Dokumen Perusahaan
Ratusan gigabyte dokumen tidak bisa dimasukkan begitu saja ke dalam model bahasa. RAG memecahnya, menyimpannya sebagai vektor, dan mengambil bagian relevan saat pertanyaan diajukan — inilah cara kerjanya beserta titik-titik yang menentukan hasilnya.
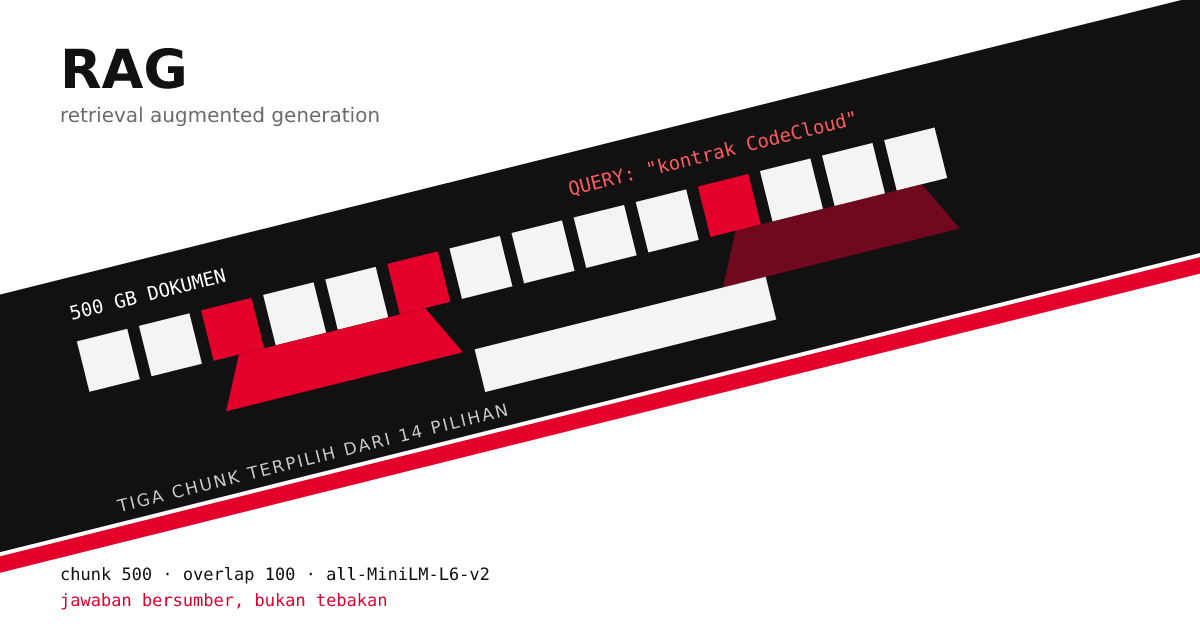
Bayangkan sebuah perusahaan menyimpan ratusan gigabyte dokumen di servernya: kontrak, kebijakan internal, catatan rapat, spesifikasi produk. Lalu muncul permintaan yang terdengar sederhana: pasang asisten AI yang bisa menjawab pertanyaan berdasarkan seluruh dokumen itu. Masalahnya langsung kelihatan. Antarmuka percakapan biasa hanya sanggup menerima belasan berkas dalam satu waktu, sementara ukuran dokumen yang harus dibaca jauh di luar kapasitas jendela konteks model bahasa mana pun.
Pendekatan yang biasa dicoba pertama kali adalah pencarian kata kunci: bangun mesin pencari yang memeringkat dokumen berdasarkan kecocokan judul dan isinya. Cara ini bertahan lama, tetapi setiap pertanyaan memaksa sistem membaca ulang seluruh kumpulan dokumen. Pendekatan kedua adalah meringkas semua dokumen terlebih dahulu. Cara ini lebih ringan, tetapi ringkasan selalu membuang detail, dan justru detail itulah yang sering ditanyakan.
Jalan keluar yang sekarang menjadi standar industri adalah RAG, kependekan dari retrieval-augmented generation. Gagasan dasarnya adalah menggabungkan dua hal: kemampuan model bahasa menyusun jawaban, dan kemampuan sistem pencarian mengambil bagian dokumen yang relevan pada saat pertanyaan diajukan.
Dari kata menjadi angka
Model bahasa tidak membaca kata, tetapi angka. Setiap potongan teks diubah menjadi representasi numerik atau embedding yang mempertahankan maknanya. Karena makna diwakili angka, dua kalimat berbeda bisa berdekatan secara matematis — misalnya "hewan peliharaan diizinkan" dan "kebijakan soal binatang di kantor" — sedangkan dua kalimat dengan kata yang mirip tetapi topik berbeda bisa berjauhan.
Semua embedding dokumen itu kemudian disimpan dalam basis data vektor. Penyimpanan inilah yang membuat pencarian menjadi efisien: sistem tidak perlu lagi memindai seluruh ratusan gigabyte berkas setiap kali ada pertanyaan.
Tiga tahap RAG
Rangkaian kerja RAG pertama kali dipopulerkan lewat makalah Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Lewis dan rekan, NeurIPS 2020). Makalah itu memperkenalkan kombinasi memori parametrik pada model seq2seq dengan memori non-parametrik berupa indeks vektor. Dalam praktiknya, alurnya terbagi tiga tahap:
- Retrieval. Pertanyaan pengguna diubah menjadi embedding dengan cara yang sama seperti dokumen, lalu dibandingkan dengan seluruh embedding dokumen. Pendekatan ini disebut pencarian semantik, karena yang dicocokkan adalah makna, bukan kata kunci statis.
- Augmentation. Hasil pencarian disisipkan ke dalam prompt pada saat proses berjalan. Ini yang membedakan RAG dari model biasa: pengetahuan yang dipakai bukan yang tersimpan sejak pelatihan, melainkan data terkini milik organisasi.
- Generation. Model menyusun jawaban berdasarkan potongan dokumen yang benar-benar diambil dari basis data. Karena itu jawaban bisa disertai sumber, dan seluruh proses berjalan tanpa perlu melatih ulang model.
Yang menentukan hasil akhir
RAG bukan tombol yang sekali ditekan langsung beres. Kualitas jawaban sangat bergantung pada tiga keputusan teknis:
- Strategi pemotongan dokumen (chunking). Ukuran dan tumpang tindih antar-potongan menentukan apakah konteks tetap utuh. Potongan terlalu kecil membuat makna terputus; terlalu besar membuat pencarian jadi tidak fokus.
- Model embedding. Pilihan model menentukan seberapa baik makna diwakili, dan sekaligus menentukan biaya komputasi. Model ringan seperti keluarga MiniLM cukup untuk banyak kebutuhan dan bisa berjalan di server biasa.
- Strategi pengambilan. Ambang batas kemiripan dan penyaringan tambahan (berdasarkan tanggal, jenis dokumen, atau departemen) mencegah potongan yang tidak relevan masuk ke konteks. Ambang yang terlalu longgar membuat jawaban keluar dari topik.
Karena itu, konfigurasi yang cocok untuk dokumen hukum tidak sama dengan konfigurasi untuk transkrip layanan pelanggan. Dokumen hukum biasanya berisi paragraf panjang dan terstruktur yang harus dijaga keutuhannya, sementara transkrip percakapan lebih cocok dipotong pada tingkat kalimat dengan tumpang tindih yang lebih besar agar konteks tetap terbaca.
Bentuk implementasi paling sederhana
Sebuah sistem RAG minimum bisa disusun dari empat komponen yang semuanya tersedia terbuka: basis data vektor seperti ChromaDB, pustaka embedding seperti Sentence Transformers, penyedia model bahasa, dan satu antarmuka web sederhana untuk menguji hasilnya. Pipeline-nya berjalan seperti ini:
- Dokumen dipecah menjadi potongan dengan ukuran dan tumpang tindih yang ditentukan, misalnya 500 karakter dengan tumpang tindih 100 karakter.
- Setiap potongan diubah menjadi vektor dan disimpan bersama metadata asalnya — nama berkas, bagian, tanggal.
- Pertanyaan pengguna diubah menjadi vektor, lalu sistem mengambil sejumlah potongan dengan kemiripan tertinggi.
- Potongan terpilih digabung menjadi konteks, lalu dikirim ke model bahasa bersama pertanyaan aslinya.
Empat komponen itu sudah cukup untuk membuktikan apakah pendekatan ini berguna untuk data tertentu. Selebihnya adalah pekerjaan penyetelan yang tidak bisa diwarisi dari proyek lain.
Keterbatasan yang perlu dihitung sejak awal
- Dokumen buruk tetap menghasilkan jawaban buruk. Berkas hasil pindaian tanpa lapisan teks, tabel kompleks, dan dokumen tanpa struktur adalah tiga jenis bahan yang paling sering merusak hasil.
- Embedding memakan biaya. Untuk korpus besar, proses awal mengubah seluruh dokumen menjadi vektor bisa memakan waktu dan sumber daya yang tidak kecil.
- Kesalahan tetap mungkin. RAG menekan kecenderungan model mengarang karena jawaban dibatasi pada potongan yang diambil, tetapi tidak menghilangkannya. Evaluasi berkala dengan pertanyaan uji tetap diperlukan.
- Data sensitif. Jika dokumen perusahaan bersifat rahasia, sistem harus dijalankan di infrastruktur sendiri, dengan model embedding lokal agar isi dokumen tidak keluar dari jaringan.
Relevansi untuk organisasi di Indonesia
Pola yang paling sering dibutuhkan di sini mirip: perusahaan dengan tumpukan dokumen internal — SOP, kontrak, laporan, arsip kepegawaian — yang selama ini hanya bisa dicari secara manual. RAG memungkinkan dokumen itu tetap berada di server sendiri sementara pencariannya menjadi cepat dan berbasis makna, bukan sekadar nama berkas.
Bagi penyedia jasa teknologi, hal ini juga membuka jenis pekerjaan yang lebih tahan lama dibanding pembuatan situs: menyiapkan pipeline data, menyetel pemotongan dokumen, dan merawat akurasi jawaban dari waktu ke waktu.
Opini: Nilai RAG tidak terletak pada model bahasanya, yang kini bisa diganti kapan saja, melainkan pada kualitas penyiapan datanya. Sebagian besar kegagalan proyek semacam ini bukan karena modelnya kurang pintar, tetapi karena pemotongan dokumen yang asal dan tidak ada evaluasi yang berkelanjutan. Konsekuensinya, pekerjaan yang paling menentukan justru terlihat paling tidak menarik: merapikan arsip, menentukan struktur, dan mengukur hasil. Prinsip yang sama berlaku bagi organisasi mana pun yang ingin memakai AI untuk pertanyaan yang jawabannya harus bisa dipertanggungjawabkan: sumber jawaban harus lebih dulu rapi daripada model yang menjawabnya.