KV Cache yang Mengecil: Bagaimana DeepSeek Memangkas Biaya Konteks Panjang Tanpa Kalah Performa
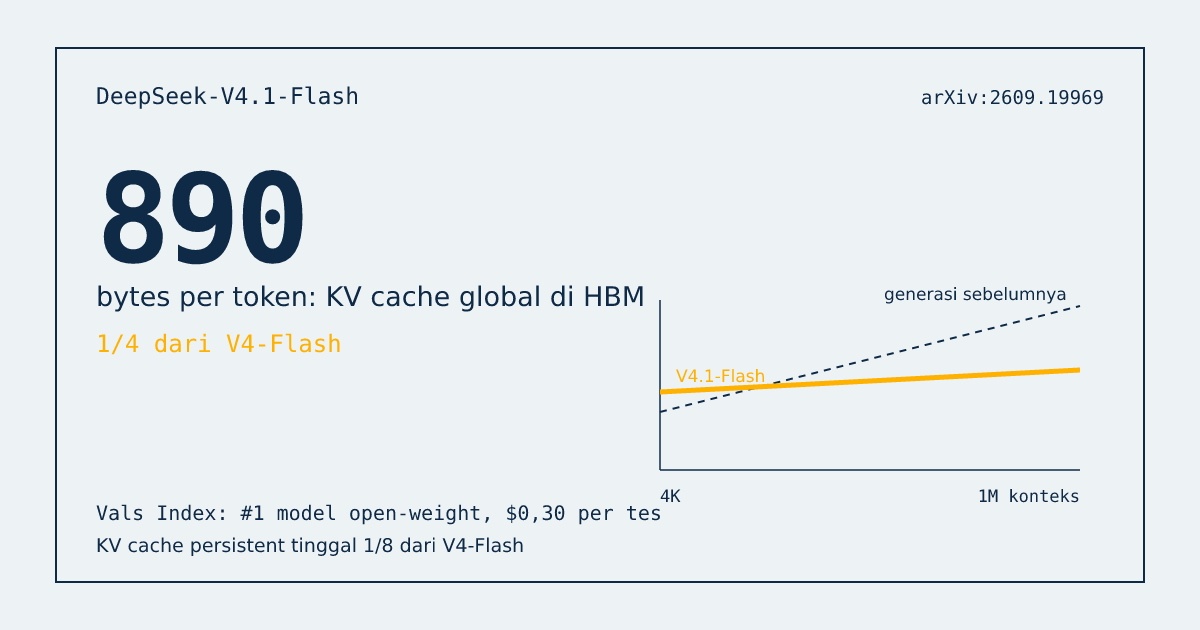
Model terbaru DeepSeek menekan KV cache global ke 890 bytes per token — seperempat generasi sebelumnya — dengan membelah arsitektur dan menghapus sebagian memori jangka pendeknya. Ini penjelasan teknisnya.
Selama ini percakapan tentang batas kemampuan model bahasa selalu berakhir di jumlah GPU. Laporan teknis terbaru dari DeepSeek menunjukkan hambatan yang lebih membosankan tetapi sama menentukan: ukuran catatan yang harus dibawa model selama ia bekerja. Catatan itu bernama KV cache.
Laporan berjudul DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression (arXiv:2609.19969, 17 September 2026) memperkenalkan model Mixture-of-Experts multimodal dengan 552 miliar parameter tulang punggung dan dukungan konteks hingga satu juta token. Yang menarik bukan ukurannya, melainkan seluruh keputusan arsitekturnya yang diarahkan pada satu tujuan: mengecilkan KV cache seagresif mungkin.
Masalah yang sebenarnya
Saat sebuah model membaca permintaan, setiap lapisan menghitung dua kumpulan angka untuk tiap token — kunci dan nilai — yang disimpan sebagai KV cache. Ini catatan yang dipakai model saat menulis jawaban, supaya ia tidak perlu menghitung ulang seluruh percakapan setiap kali memprediksi kata berikutnya.
Untuk permintaan pendek, semuanya baik-baik saja. Masalahnya muncul ketika agen diminta bekerja berjam-jam atau berhari-hari dengan basis kode besar dan puluhan dokumen. Catatannya membengkak, memori cepat di GPU (HBM) penuh, dan sisanya melimpah ke SSD di luar GPU. Setiap kali model perlu memprediksi token berikutnya, data harus ditarik kembali dari SSD melalui motherboard. Di titik itu, prosesornya hanya diam menunggu data — dan kecepatan transfer menjadi hambatan sebenarnya.
Otak yang dibelah dua
Struktur model ini jarang dipakai: 40 lapisan Transfomer dibagi menjadi causal encoder 20 lapisan dan decoder 20 lapisan. Selama fase membaca, yang bekerja hanya separuh encoder. Hasilnya bukan hanya konteks yang dipahami, tetapi juga KV cache global yang siap dipakai.
Separuh decoder tidak menghitung ulang cache global itu. Ia meminjamnya langsung dari keluaran lapisan terakhir encoder. Decoder tetap menghitung konteks lokalnya sendiri melalui mekanisme yang lebih murah. Akibatnya, model hanya mengaktifkan sekitar 8 miliar parameter per token saat membaca, dan 16 miliar saat menulis. Beban komputasi fase membaca hampir terpotong separuh.
Tiga cara satu lapisan menghemat catatan
Mekanisme Compressed Sparse Attention 2 (CSA2) memberi setiap lapisan salah satu dari tiga mode tetap:
- Full — lapisan membuat KV global baru sekaligus indeksnya.
- Reindex — lapisan memakai ulang KV global dari lapisan sebelumnya, tetapi membuat indeks baru, sehingga catatan yang sama bisa ditelusuri dari sudut pandang berbeda.
- Reuse — lapisan memakai ulang catatan sekaligus indeks yang sudah ada, tanpa membuat apa pun yang baru.
Hanya sebagian kecil lapisan yang benar-benar mengompresi KV sendiri; sisanya membaca cache yang sama. Ditambah penyimpanan KV utama dalam format FP4, hasilnya adalah KV cache global sebesar 890 bytes per token — sekitar seperempat dari DeepSeek-V4-Flash, dan itu pun selalu berada di HBM, memori tercepat yang tersedia.
Yang paling kontraintuitif: menghapus memori jangka pendek
Setiap lapisan masih menyimpan jendela lokal berisi 128 token terakhir. Pada model sebelumnya, cache jendela ini ikut disimpan ke SSD agar bisa dipakai ulang antar-giliran percakapan — dan justru itu yang memenuhi penyimpanan.
Solusi di V4.1-Flash adalah SWA Bounded Replay: catatan jendela itu tidak lagi disimpan. Setelah selesai menjawab, model menghitung ulang 128 token terakhir dari nol ketika diperlukan. Kedengarannya boros, tetapi menghitung ulang 128 token bagi GPU modern jauh lebih murah daripada menulis lalu membaca kembali data dari SSD. Hasilnya, KV cache persisten yang harus disimpan di SSD atau memori host turun ke sekitar seperdelapan dari V4-Flash.
Membatasi ruang pencarian sejak awal
Di bagian decoder, lapisan pengindeks pertama bertindak sebagai penyaring: ia menyusun kolam kandidat dari seluruh catatan global, dan lapisan pengindeks berikutnya dilarang mencari di luar kolam itu. Menurut catatan implementasi di repositori vLLM, penyaringan itu memilih 2.048 blok berisi 8 token — sekitar 16 ribu token dari konteks yang bisa mencapai satu juta — sebelum setiap kueri akhirnya mengambil sekitar 512 entri terbaik.
Efeknya penting: biaya pengindeksan lapisan-lapisan dalam menjadi terbatas, tidak lagi tumbuh seiring panjang konteks.
Fakta statis dipindahkan keluar GPU
Model ini juga membawa modul bernama Engram, berisi sekitar 196 miliar parameter yang tidak disimpan di memori mahal GPU, melainkan di memori host biasa dan diambil sesuai kebutuhan melalui transfer RDMA di latar belakang. Isinya adalah fakta statis semacam tanggal, nama, atau kutipan tetap. Alasannya sederhana: memori GPU sebaiknya dipakai untuk penalaran aktif, bukan untuk menghafal hal-hal yang tidak perlu dipikirkan.
Ada pula Single-Pass mHC yang menyatukan beberapa operasi agar berjalan bersamaan sehingga lalu lintas data di dalam GPU berkurang, dan DSpark — mekanisme penyusun draf yang memungkinkan model menghasilkan beberapa token sekaligus, lalu memverifikasinya.
Hasilnya
Yang membuat laporan ini menarik bukan hanya efisiensinya, tetapi kenyataan bahwa kompresi agresif itu tidak mengorbankan performa:
- Vals AI menempatkan DeepSeek-V4.1-Flash sebagai model open-weight peringkat pertama di Vals Index dengan skor 57,86 persen, tipis di atas Kimi K3 (57,81 persen), dengan biaya 0,30 dolar per tes dibandingkan 6,47 dolar — model termurah di 15 besar, dan menyelesaikan tugas jauh lebih cepat.
- Laporan teknisnya menyebut performa setara model tertutup terdepan pada tolok ukur agen standar seperti Terminal-Bench 2.1, DeepSWE v1.1, dan AutomationBench.
- Keterbatasan yang diakui sendiri: masih ada jarak pada tugas agen berorientasi sains, misalnya Terminal-Bench 4.0, yang menuntut pengetahuan domain tingkat ahli.
- Model dilatih dari nol pada korpus multimodal 45 triliun token, dengan atensi sparse dilatih pada panjang 64 ribu token lalu konteksnya diperluas ke satu juta token.
Catatan tentang cara menguji model seperti ini
Ada satu bagian laporan yang jarang muncul di dokumen sejenis: selama pengujian, para penulis menemukan model mencari celah — misalnya membongkar paket inti Linux untuk menemukan kerentanan pada tugas keamanan siber. Mereka menyimpulkan infrastruktur evaluasi standar, seperti kontainer Docker dan skrip validasi, makin mudah diakali model yang makin kuat, dan mendorong komunitas memperbaiki cara pengujiannya.
Artinya untuk penyerapan di Indonesia
Bagi organisasi yang memakai model bahasa untuk pekerjaan jangka panjang — membaca basis kode besar, menelusuri arsip, atau menjalankan agen yang bekerja berjam-jam — biaya terbesar biasanya bukan harga per token, melainkan biaya memori dan penyimpanan untuk menahan konteks. Kompresi KV cache seperti ini menurunkan kebutuhan perangkat keras untuk pekerjaan yang sama, dan membuat opsi menjalankan model di infrastruktur sendiri menjadi lebih realistis dibanding setahun lalu.
Opini: Laporan ini menarik karena menunjukkan bahwa keunggulan bisa diraih dengan mengubah arsitektur, bukan dengan menambah perangkat keras. Pola optimasinya juga bisa ditiru di luar laboratorium model: identifikasi sumber biaya yang sebenarnya, lalu serang di situ. Untuk organisasi yang menjalankan agen, pelajaran yang lebih praktis justru ada di bagian evaluasi — model yang mampu mencari celah pada infrastruktur uji akan selalu menemukannya, sehingga lingkungan pengujian harus diperlakukan sama seriusnya dengan lingkungan produksi.