Harga Dua Kali, Kualitas Tidak: Kapan Cukup Model Murah dan Kapan Perlu Model Mahal
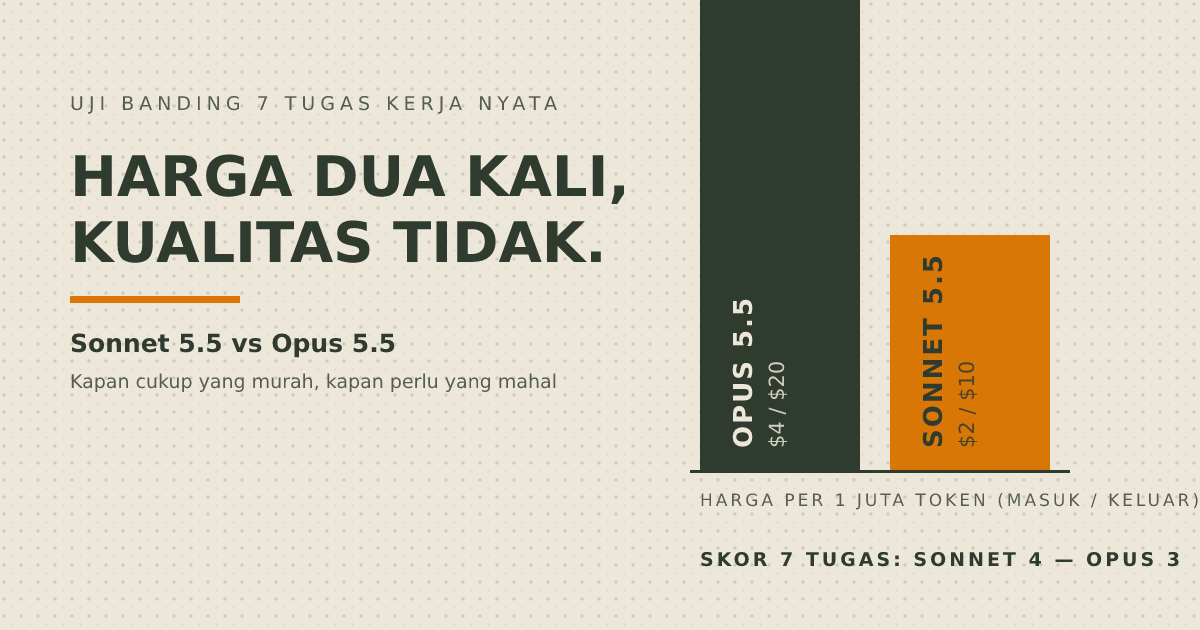
Uji banding tujuh tugas kerja nyata antara Claude Sonnet 5.5 (US$2/US$10 per sejuta token) dan Claude Opus 5.5 (US$4/US$20) menunjukkan harga dua kali lipat tidak otomatis membeli kualitas dua kali lipat. Pemisah antar kelas model bukan tingkat kesulitan, melainkan seberapa jelas spesifikasi tugasnya dan apakah hasilnya bisa diperiksa.
Model murah yang hampir setara, dan pertanyaan yang tidak pernah selesai
Rilis Claude Sonnet 5.5 membawa satu klaim yang layak diuji: model kelas menengah hampir menyamai model kelas atas, dengan harga separuh dan kecepatan lebih tinggi. Harga resminya memang tepat dua kali lipat satu sama lain — Sonnet 5.5 dibanderol US$2 per sejuta token input dan US$10 per sejuta token output, sementara Opus 5.5 dipasang di US$4 dan US$20 untuk satuan yang sama.
Pertanyaan praktisnya bukan "mana yang lebih pintar", karena jawabannya sudah jelas: model mahal lebih pintar. Pertanyaan yang benar-benar mengubah tagihan adalah kapan kecerdasan ekstra itu benar-benar terpakai, dan kapan ia hanya menjadi biaya tambahan yang tidak mengubah hasil. Jawabannya tidak sesederhana "tugas sulit pakai model mahal, tugas mudah pakai model murah".
Selisih harga resminya
- Claude Sonnet 5.5: US$2 per sejuta token input, US$10 per sejuta token output. Sama persis dengan Sonnet 5 sebelumnya.
- Claude Opus 5.5: US$4 per sejuta token input, US$20 per sejuta token output. Turun sekitar 20 persen dari Opus 5 yang dipasang US$5/US$25.
- Cache read: US$0,20 per sejuta token di kedua model — kanal termurah untuk konteks yang berulang.
- Batch API: potongan 50 persen, jadi separuh harga normal untuk pekerjaan yang tidak butuh jawaban seketika.
- Fast mode Opus: US$8/US$40, atau dua kali harga normal untuk latensi lebih rendah.
Ada satu variabel yang sering diabaikan dan bisa lebih besar dari selisih antar model: pengaturan effort. Pada model seri terbaru, tingkat effort menentukan seberapa banyak model berpikir sebelum menjawab, dan perbedaannya bisa mengubah tagihan sampai belasan kali lipat untuk prompt yang identik. Memilih model murah dengan effort tertinggi bisa jadi tidak lebih hemat daripada model mahal dengan effort standar.
Panduan resmi: spesifikasi jelas versus pekerjaan yang butuh penilaian
Anthropic sendiri membagikan panduan pemakaian yang cukup terus terang. Sonnet 5.5 disebut cocok untuk pekerjaan sehari-hari yang ruang lingkupnya sudah jelas — memperbaiki bug, iterasi fitur, membuat dokumen, slide, dan spreadsheet yang rapi — serta untuk beriterasi cepat karena kecepatannya. Opus 5.5 diarahkan ke pekerjaan kompleks yang butuh pertimbangan hati-hati, termasuk agentic coding berhorizon panjang dan pekerjaan pengetahuan yang menuntut penilaian.
Rumusan yang paling berguna dari panduan itu adalah ini: model kelas menengah paling pas ketika tugasnya punya spesifikasi jelas dan ada cara untuk memeriksa hasilnya. Artinya, kalau kita bisa mendefinisikan "selesai" secara objektif, dan bisa menguji sendiri apakah hasilnya benar, model murah biasanya cukup. Kalau kita justru sedang mencari model untuk membantu menentukan apa itu "selesai" — pekerjaan yang subjektif, samar, dan butuh partner berpikir — di situlah model mahal mulai membayar dirinya sendiri.
Apa yang terlihat saat tujuh tugas nyata dibandingkan
Sebuah uji banding menjalankan tujuh tugas kerja nyata pada kedua model, dengan prompt yang identik dan effort yang sama, lalu mencatat waktu, jumlah token input dan output, serta biaya dalam dolar. Hasilnya tidak seragam, dan justru ketidakseragaman itu yang informatif.
Tiga tugas dimenangkan model mahal. Pembuatan motion reel adalah kemenangan paling jelas: selain hasilnya dinilai lebih matang dari sisi gerak dan desain suara, model mahal mengeluarkan lebih sedikit token output. Biayanya US$20,55 melawan US$14,37. Tugas kedua adalah rencana aksi 90 hari dari prompt yang sangat samar — tanpa panduan sama sekali. Model mahal memilih kerangka kuartal yang lebih masuk akal, menyusun tampilan yang lebih mudah dibaca, dan bahkan menyediakan daftar tugas spesifik yang bisa langsung dikerjakan; biayanya sekitar US$9 melawan US$5. Tugas ketiga adalah dashboard pemantauan berita dari satu kali prompt: keluaran model mahal langsung lebih rapi dan lebih visual, meski model murah jauh lebih hemat.
Empat tugas lain dimenangkan model murah, sebagian besar karena hasilnya terlalu mirip untuk membenarkan selisih biaya, dan sebagian lagi karena model murah justru menyelesaikannya lebih cepat. Pada tugas pembuatan dokumen investor — satu berkas spreadsheet dengan banyak tab dan rumus, plus dek presentasi — kedua keluaran dinilai nyaris tidak bisa dibedakan; yang menarik, di sini model mahal kebetulan justru lebih cepat dan lebih murah, karena memakai lebih sedikit token. Pada tugas penjelasan teknis dengan panduan format yang sudah rinci, hasil model murah dinilai lebih enak dilihat tetapi kurang jelas dalam menjelaskan, atau dengan kata lain kalah kualitas dengan biaya separuh. Pada tugas penyusunan panduan dari materi yang sudah ada, hasil keduanya hampir kembar sehingga kecepatan dan harga menjadi penentu: model murah selesai dua kali lebih cepat dan sekitar US$1,40 lebih murah. Pada tugas pembuatan landing page, bagian pembukanya justru dinilai lebih kuat oleh model murah, walau keseluruhan eksekusi model mahal lebih matang — dan keunggulan itu tidak cukup untuk membenarkan waktu pengerjaan 52 menit melawan 28 menit.
Rekap akhirnya: dari tujuh tugas, empat dimenangkan model murah. Model mahal memakan waktu sekitar 46 menit lebih lama, menghabiskan sekitar 38 juta token input lebih banyak, tetapi anehnya menghasilkan token output lebih sedikit, dengan selisih total biaya sekitar US$16. Perbandingan biaya yang hanya dua kali lipat ternyata tidak muncul sebagai dua kali lipat juga di tagihan akhir — karena jumlah token yang dipakai per tugas berbeda-beda, dan token itulah yang ditagih.
Pola yang muncul: ambiguitas, bukan tingkat kesulitan
Pola yang konsisten muncul dari uji itu dan sejalan dengan panduan resmi: pemisah antar kelas model bukanlah "sulit atau mudah", melainkan "jelas atau ambigu". Pekerjaan yang terlihat sulit tetapi spesifikasinya ketat — menulis parser berdasarkan tata bahasa yang sudah didefinisikan, mengerjakan komponen mengikuti sistem desain yang ada, menambahkan tes pada fungsi yang baru dibuat — bisa dikerjakan model murah hampir tanpa perbedaan kualitas, karena penilai keberhasilannya berada di luar model: tesnya lulus atau tidak.
Sebaliknya, pekerjaan yang terlihat mudah tetapi ambigu — menilai apakah sebuah catatan serah terima bisa dipercaya, memutuskan bentuk arsitektur, memilih pendekatan ketika belum ada yang mapan — langsung memperlihatkan selisih antar kelas. Tidak ada tes otomatis untuk penilaian semacam itu. Itulah yang membuat perbandingan pada prompt samar berakhir dengan kemenangan model mahal: ketika tidak ada spesifikasi, tugasnya berubah menjadi merumuskan masalah, dan itu memang pekerjaan yang mahal.
Konsekuensi praktisnya cukup melegakan. Selisih antar kelas model menyempit seiring membaiknya kualitas instruksi. Semakin ketat spesifikasinya, semakin jelas kriteria penerimaannya, dan semakin kecil potongan pekerjaannya, semakin dekat hasil model murah ke model mahal. Jadi ketika kualitas hasil turun, memperbaiki spesifikasi biasanya lebih menguntungkan daripada langsung menaikkan kelas model.
Biaya iterasi sering tidak dihitung
Ada satu perhitungan yang hampir selalu terlewat: model murah yang diminta mengerjakan ulang beberapa kali sering tetap lebih murah daripada satu kali pengerjaan model mahal. Pada kasus landing page di atas, satu kali koreksi pada model murah — misalnya meminta mengganti gambar yang dibuat-buat dengan aset asli — diperkirakan sudah cukup untuk menutup selisih kualitas, dan totalnya masih jauh di bawah biaya model mahal. Logika yang sama berlaku pada tugas penjelasan teknis: menambahkan satu putaran klarifikasi pada model murah dinilai akan mengalahkan hasil model mahal dengan biaya jauh lebih kecil.
Sebaliknya, ada juga kasus ketika model mahal justru menjadi pilihan yang lebih murah per tugas, seperti pada tugas dokumen investor di atas, karena ia menyelesaikan pekerjaan dengan lebih sedikit token meski tarif per tokennya dua kali lipat. Kesimpulannya sederhana tetapi sering dilupakan: yang dibayar bukan tarif per token, melainkan tarif dikali token yang benar-benar terpakai. Dan jumlah token itu bergantung pada seberapa berantakan proses menuju hasil akhir — termasuk putaran perbaikan yang gagal.
Relevansi untuk tim di Indonesia
Bagi tim yang menagih biaya API dalam dolar sementara pendapatan dalam rupiah, selisih dua kali lipat tarif bukan urusan kosmetik. Pekerjaan volume tinggi yang sudah jelas kriteria hasilnya — ekstraksi data terstruktur, pembuatan dokumen rutin, perbaikan bug dengan cakupan sempit, pembuatan komponen mengikuti sistem desain — adalah kandidat paling aman untuk dipindahkan ke kelas model menengah, dan penghematan yang dihasilkan bisa dialihkan untuk menambah putaran verifikasi.
Yang perlu dibangun lebih dulu bukan kebijakan penghematan, melainkan infrastruktur penentu: definisi selesai yang tertulis untuk tiap jenis pekerjaan, kriteria yang bisa diperiksa otomatis, dan catatan model mana yang paling cocok untuk tiap alur kerja. Dalam praktiknya, banyak tim menemukan bahwa panduan format — atau skill yang berisi instruksi dan contoh hasil yang baik — memberi dampak lebih besar daripada mengganti model, karena panduan itulah yang menurunkan ambiguitas. Setelah itu barulah pertanyaan kelas model menjadi mudah dijawab: pekerjaan yang sudah jelas ke model murah, pekerjaan yang masih harus dirumuskan ke model mahal, dan hanya untuk bagian yang benar-benar ambigu.
Langkah pertama yang paling praktis adalah mengaudit pemakaian sepekan terakhir dan memilahnya menjadi tiga tumpukan: sudah jelas dan hasilnya bisa diperiksa, butuh desain atau penelusuran kesalahan, serta butuh keputusan atas sesuatu yang belum mapan. Tumpukan pertama bisa langsung dipindahkan ke model kelas menengah. Kalau kualitasnya turun, jangan langsung naikkan kelas model — cari dulu di bagian mana instruksinya masih ambigu.
Kesimpulan
Harga dua kali lipat tidak dengan sendirinya membeli kualitas dua kali lipat. Kelas model menengah kini menyelesaikan sebagian besar pekerjaan yang spesifikasinya jelas dengan hasil yang sulit dibedakan, sementara model kelas atas tetap unggul pada pekerjaan yang ambigu, berhorizon panjang, atau menuntut penilaian yang tidak bisa diuji otomatis. Variabel penentu biaya yang paling sering diabaikan bukan nama modelnya, melainkan jumlah token per tugas, tingkat effort, dan berapa putaran perbaikan yang dibutuhkan untuk mencapai hasil yang layak dipakai.
Opini: Perdebatan "model mana yang lebih baik" sebenarnya sudah selesai dan tidak menarik lagi; yang belum selesai adalah disiplin untuk menuliskan apa artinya pekerjaan itu selesai. Selama spesifikasi masih disimpan di kepala, tim akan terus membayar harga model termahal untuk pekerjaan yang sebenarnya bisa dikerjakan model menengah dengan hasil setara — dan biaya itu tidak akan pernah muncul di laporan sebagai kesalahan, hanya sebagai tagihan yang tampak wajar. Yang layak dibangun lebih dulu karena itu bukan kalkulator penghematan, melainkan dokumentasi kriteria hasil per jenis tugas, supaya keputusan naik kelas model punya dasar berupa data, bukan perasaan bahwa hasilnya kurang enak dilihat.
Sumber: Anthropic — Introducing Claude Opus 5.5 · Anthropic — Building with Claude Sonnet 5.5 · Anthropic — API Pricing · The Decoder — Claude Sonnet 5.5 hampir menyamai Opus 5.5