Dari Wajah ke Vektor 512-Dimensi: Penelaahan Teknis Ekstraksi Fitur, Komparasi, dan Anti-Spoofing pada Microservice Biometrik Wajah
Penelaahan teknis microservice biometrik wajah: ekstraksi embedding ArcFace vs AdaFace (perbandingan kuantitatif arsitektur), komparasi cosine 1:1/1:N di pgvector, ambang adaptif berbasis kualitas citra, deteksi serangan presentasi SSDG+MTCNN — plus pipeline fine-tuning dan metrik targetnya.
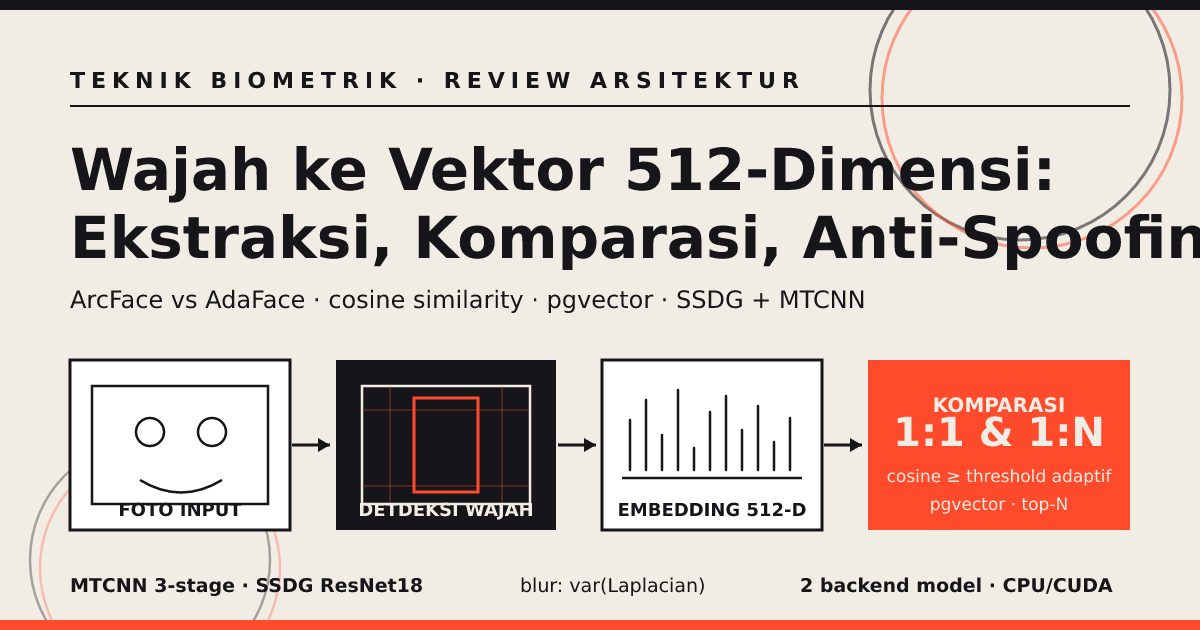
Abstrak. Artikel ini menelaah secara teknis sebuah microservice verifikasi biometrik wajah: bagaimana citra wajah diubah menjadi vektor numerik berdimensi 512, bagaimana dua vektor dibandingkan untuk verifikasi satu-satu (1:1) maupun pencarian satu-ke-banyak (1:N), bagaimana dua keluarga model embedding yang berbeda (ArcFace ResNet-50 dan AdaFace IR-101) dapat diganti per lingkungan, dan bagaimana mekanisme deteksi serangan presentasi (anti-spoofing) bekerja di lapisan terpisah. Penelaahan mencakup arsitektur sistem, ekstraksi fitur, penilaian kualitas citra dengan ambang adaptif, penyimpanan vektor berbasis pgvector, serta pipeline fine-tuning model. Semua mekanisme diuraikan berdasarkan implementasi kode yang terdokumentasi, disertai metrik target yang ditetapkan proyek, bukan hasil pengukuran eksternal.
Pendahuluan
Sistem pengenalan wajah modern pada intinya adalah masalah representasi: mengubah citra wajah — yang sangat peka terhadap pencahayaan, sudut, ekspresi, dan aksesoris — menjadi vektor berdimensi tetap di ruang numerik, sedemikian rupa sehingga jarak antar vektor merepresentasikan kemiripan identitas. Kualitas seluruh sistem turun-tembus dari kualitas representasi itu: deteksi, komparasi, pencarian, hingga keamanannya.
Implementasi yang ditelaah di sini memisahkan empat tanggung jawab ke dalam empat komponen yang masing-masing dapat diganti: deteksi dan penyelarasan wajah, ekstraksi embedding, penyimpanan dan pencarian vektor, serta deteksi serangan presentasi. Pemisahan ini penting karena empat komponen itu gagal dengan mode yang berbeda — dan karenanya perlu dievaluasi, dikonfigurasi, dan diperbarui secara terpisah.
Arsitektur Sistem
Topologi
Alur datanya linier: klien → proxy reverse (Caddy) → aplikasi FastAPI (Python 3.11, Uvicorn) → PostgreSQL 15 dengan ekstensi pgvector. Antarmuka administrasi berupa SPA React + Vite + TypeScript yang menempel di aplikasi yang sama melalui lapisan API terpisah. Seluruh komponen dijalankan dalam Docker via docker-compose; proxy menangani TLS otomatis (Let's Encrypt), HSTS, dan pembatasan laju, baik per-IP maupun per-token API.
Lapisan aplikasi
- Lapisan API publik (
/api/v1) — empat endpoint inti:extract(foto → embedding → tersimpan),compare/1to1,compare/1ton, danerasure(penghapusan data). Autentikasi: Bearer token, disimpan dalam bentuk hash, dapat dicabut dan memiliki masa berlaku. - Lapisan API antarmuka (
/ui/api) — login, manajemen pengguna, token, statistik, dan laporan. Autentikasi: JWT HS256 dalam httpOnly cookie, dengan kontrol akses berbasis peran. - Lapisan layanan — tujuh service terisolasi: face (model), vector (pgvector), compare (orkestrasi 1:1/1:N), user, token, stats, dan audit.
- Lapisan inti — konfigurasi terpusat (pydantic-settings), kriptografi, resolusi perangkat (CPU/CUDA), dan exception handler.
Skema basis data dikelola melalui migrasi Alembic (tujuh versi), mulai dari tabel awal hingga kolom-kolom deteksi spoofing dan manajemen klien. Di sisi operasional, CI/CD menjalankan lint, test suite, audit dependensi, dan build container secara berurutan; test suite terdiri atas 219 fungsi test dengan gerbang coverage 80%, dijalankan di SQLite in-memory dengan tabel pgvector di-mock sehingga tidak membutuhkan PostgreSQL fisik.
Ekstraksi Fitur Wajah
Alur deteksi — embedding
Input berupa citra base64 didekode menjadi array BGR. Alur yang berlaku: decode → deteksi wajah → validasi jumlah (tepat satu; nol memicu FaceNotFound, lebih dari satu memicu MultiFace) → ekstraksi embedding 512-dimensi → (opsional) penyimpanan keyed by hash identitas nasional. Model dimuat secara lazy pada pemanggilan pertama dan di-cache sebagai singleton kelas, dengan provider eksekusi dipilih dari konfigurasi: CPUExecutionProvider untuk CPU, atau CUDAExecutionProvider + fallback CPU untuk GPU.
Backend model A — ArcFace ResNet-50 (InsightFace buffalo_l)
Backend default adalah paket buffalo_l dari InsightFace, yang memuat detektor RetinaFace (input deteksi 640×640) dan pen-embedding ArcFace berbasis ResNet-50. Detektor menghasilkan kotak wajah plus titik-titik landmark; penyelarasan ke crop 112×112 dilakukan di dalam pipeline. Inference berjalan melalui ONNX Runtime. Setiap embedding yang disimpan membawa string versi model (insightface-buffalo-l-arcface-r50) sehingga jejak model per-vektor dapat diaudit.
Backend model B — AdaFace IR-101
Backend alternatif menggunakan pen-embedding AdaFace berbasis IR-101 (ResNet-101) dengan checkpoint MS1MV3, dipasangkan dengan detektor MTCNN. Penyelarasan menghasilkan crop 112×112 yang sama. Inference melalui PyTorch, dan versi model diturunkan otomatis dari nama checkpoint sehingga dua model dapat beroperasi berdampingan di lingkungan berbeda tanpa mengubah skema data.
Perbandingan kedua backend
Kedua backend dipilih per lingkungan melalui satu variabel konfigurasi (FACE_MODEL_BACKEND). Perbandingan kuantitatif kapasitas arsitekturnya disajikan pada Figur 1. Angka IR-101 dihitung eksak dari definisi layer di kode sumber; ResNet-50 memakai arsitektur standar torchvision dengan head embedding 512-dimensi. Selisih parameter — bukan akurasi — yang dapat dibuktikan secara faktual dari implementasi:
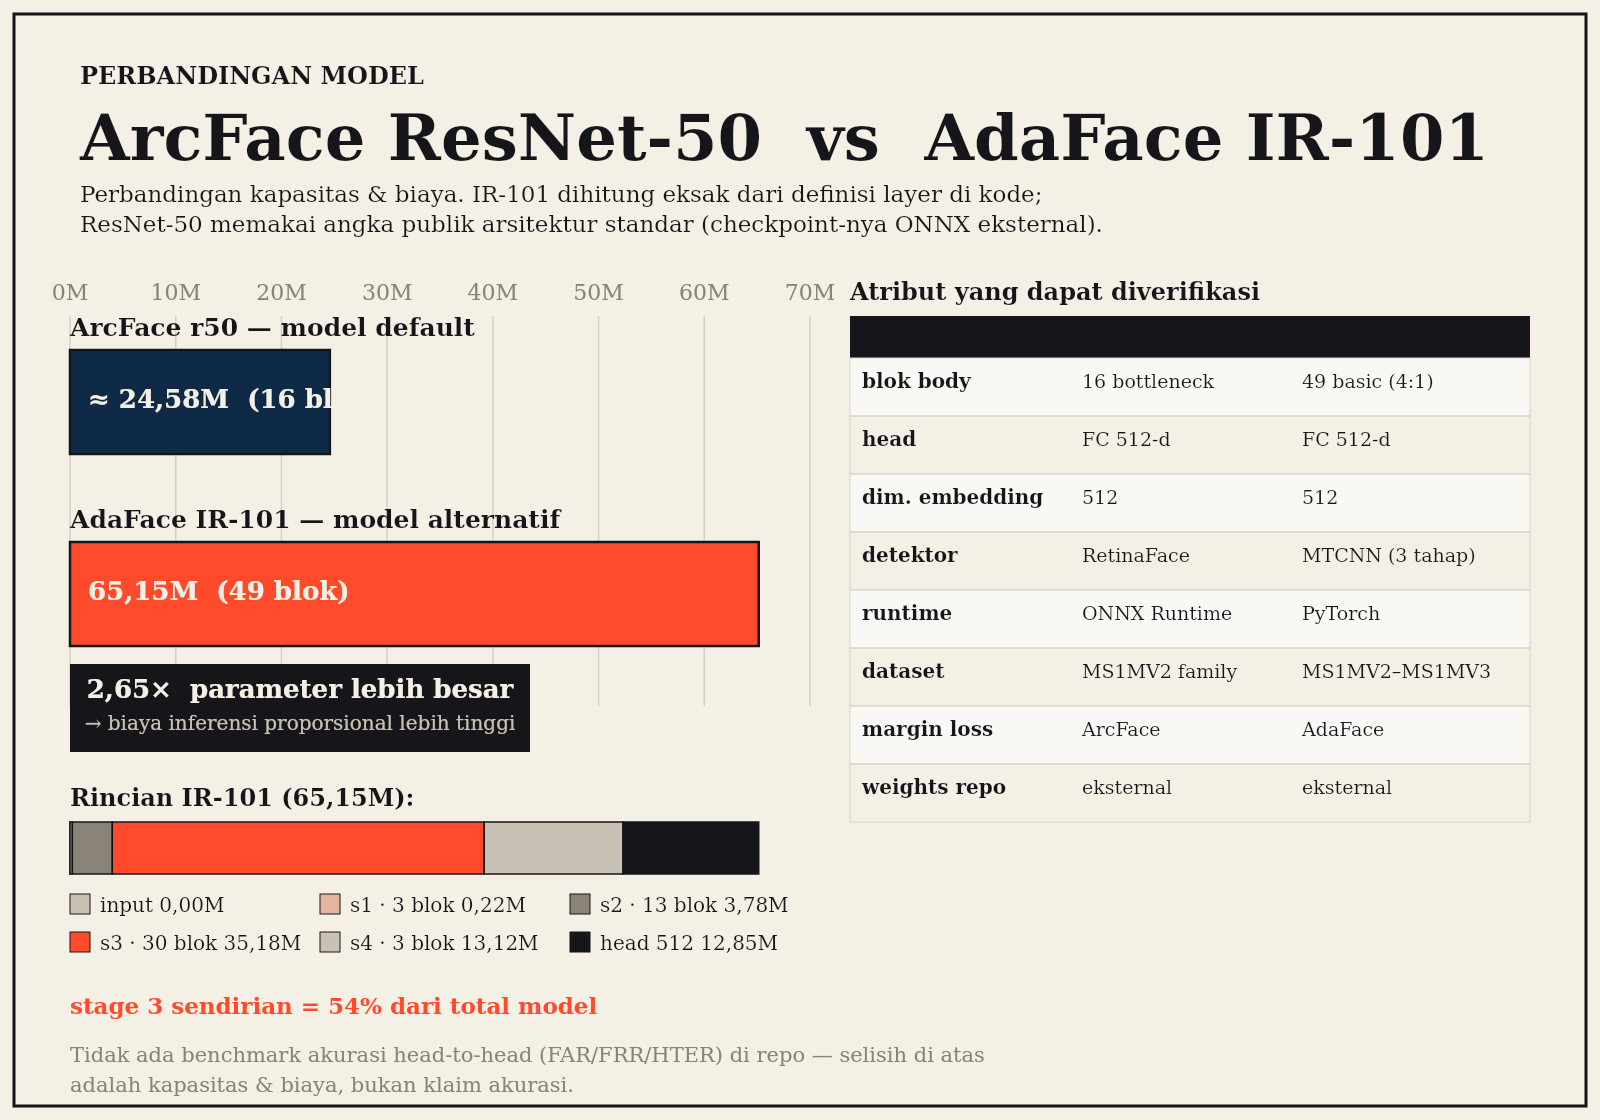
Figur 1. Kapasitas arsitektur: ArcFace ResNet-50 (≈24,58M parameter) versus AdaFace IR-101 (65,15M parameter, dihitung eksak dari definisi layer). Rasio 2,65× merepresentasikan kapasitas dan biaya inferensi, bukan keunggulan akurasi — tidak ada benchmark head-to-head (FAR/FRR/HTER) dalam proyek ini.
- ArcFace ResNet-50 (buffalo_l): pen-embedding ResNet-50, 512-d; detektor RetinaFace terintegrasi pada paket multi-tugas; input deteksi 640×640; runtime ONNX; profil ringan dan cepat, cocok sebagai default operasional di CPU maupun GPU. Terlatih pada dataset besar umum (keluarga MS1MV2) sehingga coverage demografinya luas.
- AdaFace IR-101 (MS1MV3): pen-embedding ResNet-101, 512-d; detektor MTCNN terpisah (tiga tahap cascade, minimum ukuran wajah 80 px); runtime PyTorch; backbone lebih dalam — kapasitas representasi lebih besar dengan biaya inferensi lebih tinggi. Arsitektur AdaFace dikenal dalam literatur karena margin loss adaptif yang membuatnya lebih toleran terhadap variasi pencahayaan dan oklusi dibanding ArcFace standar; checkpoint MS1MV3-nya dilatih pada dataset multi-modal yang lebih besar dari generasi sebelumnya.
Konsekuensi praktisnya: keduanya menghasilkan vektor 512-d yang tidak se-ruang — embedding dari backend A tidak dapat dibandingkan langsung dengan embedding dari backend B. Karena itu versi model dicatat per baris vektor, dan pergantian backend pada skala produksi menyiratkan regenerasi koleksi embedding, bukan sekadar ganti variabel lingkungan.
Detektor MTCNN: cascade tiga tahap
MTCNN (Multiple Task CNN) yang digunakan pada backend B dan modul anti-spoofing bekerja sebagai cascade tiga jaringan: PNet (input multi-scale, stride 12 px) menghasilkan kandidat kotak wajah pada setiap skala gambar yang di-zoom-out bertahap (faktor 0.707); RNet (input 24×24) menyaring kandidat; ONet (input 48×48) memberi presisi akhir plus lima titik landmark. Setiap tahap menerapkan threshold probabilitas 0.7, non-maximum suppression (IoU 0.7), kalibrasi offset kotak, dan konversi ke kotak persegi. Hasil akhirnya adalah crop wajah terbesar berukuran 112×112 — sama persis dengan resolusi input yang diharapkan pen-embedding.
Teknik Komparasi
Verifikasi 1:1
Verifikasi satu-satu mem-embed kedua citra, lalu menghitung similaritas kosinus:
score = (a · b) / (‖a‖ × ‖b‖)
Hasilnya dibatasi [0, 1] untuk vektor ternormalisasi. Keputusan match dihasilkan dari perbandingan skor dengan ambang adaptif, bukan konstan (dibahas pada bagian penilaian kualitas citra). Target latensi layanan untuk operasi ini di bawah 500 ms.
Pencarian 1:N
Pencarian satu-ke-banyak mem-embed citra query sekali, lalu menyerahkan vektor ke PostgreSQL: operator jarak kosinus pgvector (<=>) dipakai dengan rumus score = 1 − jarak, diurutkan menurun, dibatasi top-N, dan difilter oleh skor minimum adaptif. Target yang ditetapkan: di bawah satu detik untuk koleksi 100.000 vektor — tercapai berkat indeks vektor di Postgres itu sendiri, tanpa basis data vektor terpisah. Setiap hasil diberi label kepercayaan: high (skor ≥ ambang match), medium (skor ≥ skor minimum adaptif), atau low. Penyimpanan memakai upsert keyed by hash identitas nasional (ON CONFLICT … DO UPDATE), sehingga rekam wajah per-subjek tunggal dan selalu versi-terbaru.
Penilaian kualitas citra dan ambang adaptif
Komparasi biometrik yang hanya memakai ambang tetap akan salah menolak wajah yang foto buramnya. Implementasi ini menyelesaikannya dengan modul penilaian kualitas berbasis tiga metrik klasik OpenCV:
- Kecerahan — mean piksel abu-abu (band ideal 80–180);
- Ketajaman — varians Laplacian (band: <100 sangat buram, 100–200 buram, 200–500 memadai, >500 tajam);
- Kontras — simpangan baku (band ideal >50).
Ketiganya dinormalisasi ke skor 0–1 dan digabungkan berbobot: kualitas = 0.30×kecerahan + 0.40×ketajaman + 0.30×kontras — ketajaman diberi bobot terbesar. Fungsi ambang adaptif hasil kombinasinya disajikan pada Figur 2:
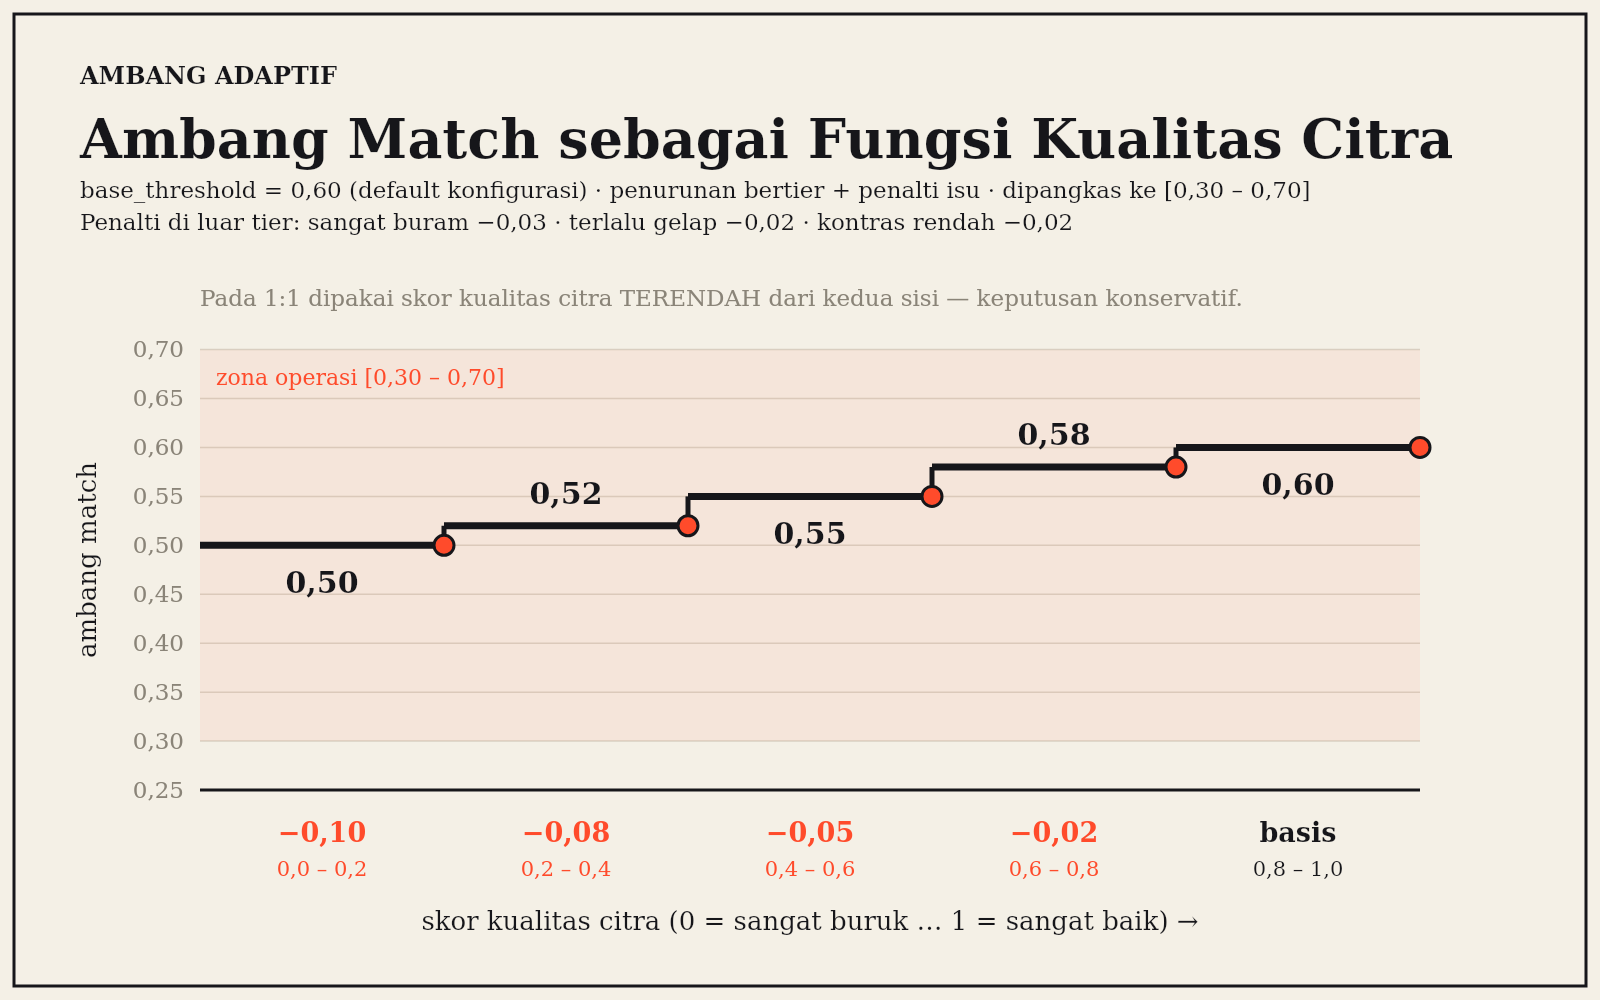
Figur 2. Fungsi ambang match adaptif: dari ambang dasar 0,60, ambang diturunkan bertier mengikuti skor kualitas citra (0,58 / 0,55 / 0,52 / 0,50), plus penalti buram ekstrem −0,03, terlalu gelap −0,02, kontras rendah −0,02; hasil akhir dipangkas ke rentang [0,30 – 0,70].
Pada 1:1, kualitas yang dipakai adalah kualitas terendah dari kedua citra — keputusan konservatif: kualitas kedua sisi harus memadai. Respons memuat skor, match, ambang akhir, ambang dasar, dan diagnosis kualitas per-citra sehingga pemanggil API dapat menelusuri mengapa sebuah match ditolak.
Anti-Spoofing (Deteksi Serangan Presentasi)
Modul anti-spoofing menjawab pertanyaan yang berbeda dari pengenalan: apakah citra ini orang sungguhan atau presentasi (foto, layar, masker)? Implementasinya memakai dua komponen: MTCNN (bagian detektor cascade) untuk deteksi dan crop, serta model klasifikasi SSDG berbasis ResNet-18 untuk klasifikasi real/fake.
Arsitektur model SSDG
- Backbone — ResNet-18 hingga layer 3 (feature extraction), opsional dengan pretrained weights.
- Feature embedder — layer 4 + average pooling + fully-connected 512, dengan normalisasi L2 p=0.5 — pola normalisasi yang umum pada pen-embedding margin-based.
- Classifier — fully-connected 512→2 tanpa bias, dengan bobot yang dinormalisasi L2 per-neuron sebelum forward pass — ekuivalen matematis dari pen-embedding ArcFace, yang membuat probabilitasnya berperilaku seperti kosinus similarity antara vektor sampel dan bobot kelas.
Alur keputusan
Alurnya: decode → MTCNN crop wajah (gagal deteksi langsung diklasifikasikan sebagai spoof — perilaku fail-closed) → resize 256×256, normalisasi ImageNet → forward SSDG → softmax dua kelas. Probabilitas kelas real kemudian di-remap: nilai dalam rentang (0.35, 0.9) dipetakan ke (0.60, 0.90), mempertajam pembedaan di zona tengah. Keputusan akhir: spoof_score < 0.80 → spoof (ambang default, bisa dikonfigurasi). Modul ini opsional per-pemanggilan (check_spoof), dijalankan pada kedua citra di endpoint 1:1, dan model blur-detection ONNX bersifat fakultatif — bila checkpoint tidak ada, gerbang blur dilewati tanpa merusak alur. Semua model dimuat lazy, dilindungi lock thread, dan dapat beroperasi di CPU atau CUDA.
Fine-Tuning Model
Untuk populasi atau kondisi pengambilan yang spesifik (pencahayaan kamera tetap, variasi aksesoris seperti kacamata atau hijab), pipeline fine-tuning ArcFace terdokumentasi dengan format dataset per-orang (satu direktori per kelas): minimum 10 orang × 10 citra, rekomendasi 50+ orang × 30–50 citra, resolusi minimum 200×200 px dengan wajah ≥100×100 px, satu wajah per citra. Variasi (sudut, pencahayaan, ekspresi, dengan/tanpa aksesoris) dinyatakan eksplisit sebagai faktor penting — 30 citra tajam dinilai lebih berharga daripada 100 citra buram.
Training dijalankan GPU (~10 GB VRAM untuk batch 64) dengan default: 10 epoch, learning rate 10⁻⁺, deteksi 640 px, split validasi 15%. Output: best_model.pth (akurasi validasi tertinggi), final_model.pth, dan metadata.json. Model hasil fine-tune dipasang melalui satu variabel lingkungan, dan versi model yang tercatat per-embedding mengikuti otomatis. Metrik target yang ditetapkan (bukan hasil pengukuran) disistematisasikan pada Figur 3:
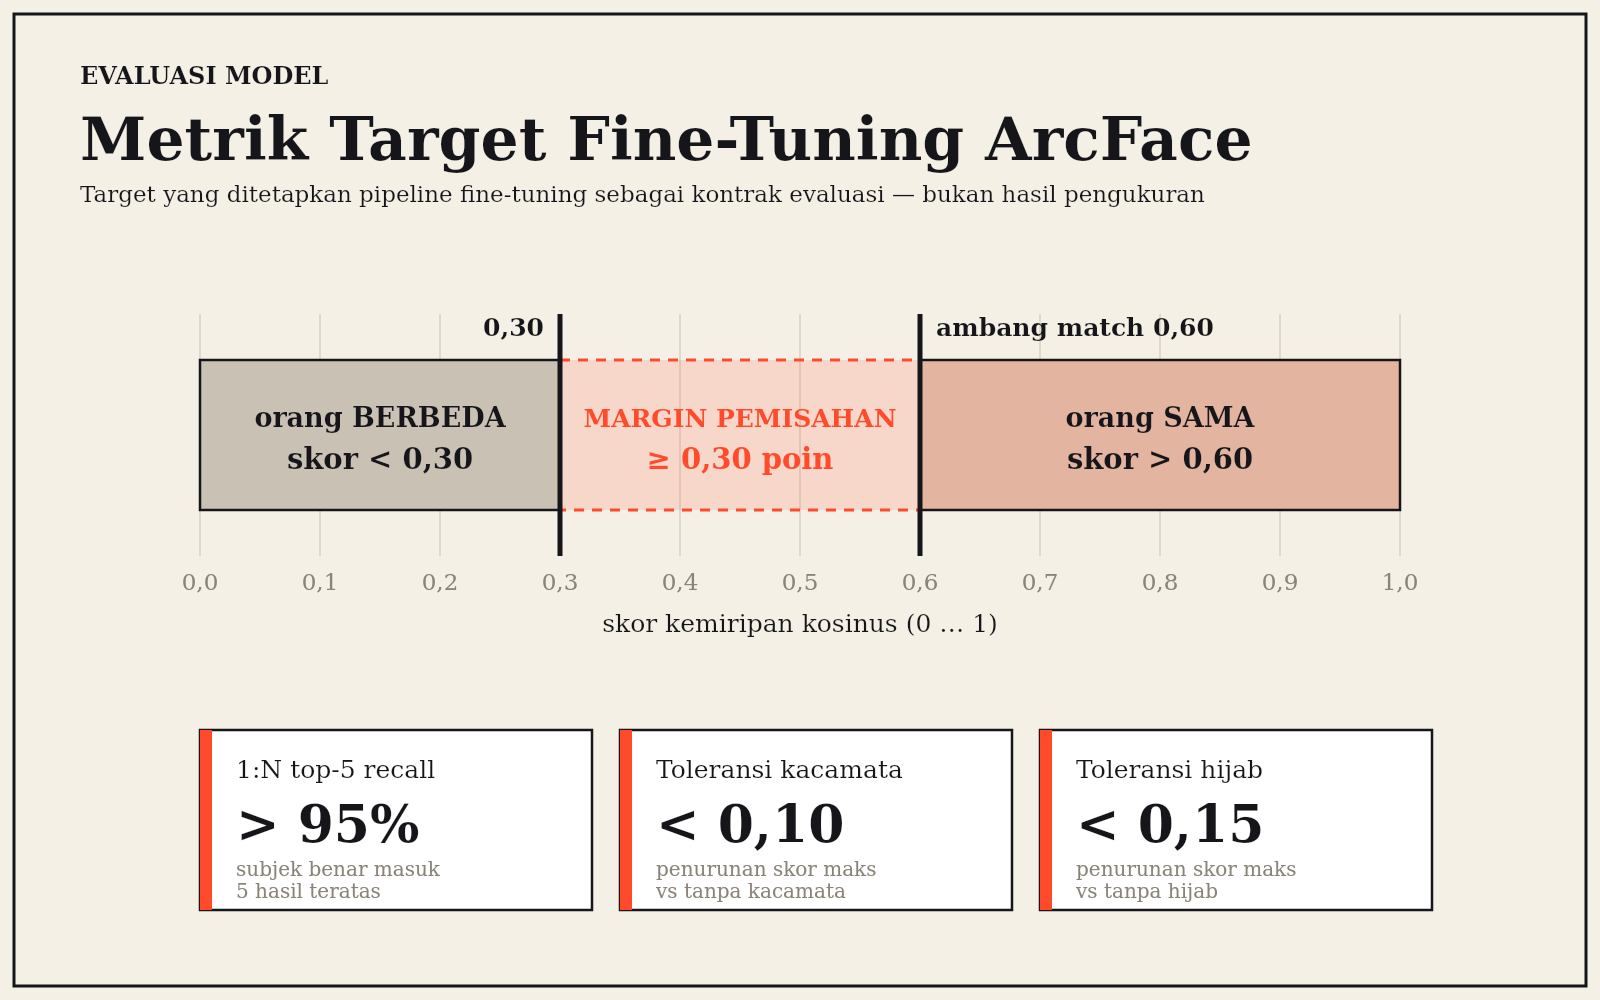
Figur 3. Kontrak evaluasi fine-tuning: skor orang-sama harus > 0,60, orang-berbeda < 0,30 (margin pemisahan ≥ 0,30 poin), top-5 recall 1:N > 95%, penurunan skor akibat kacamata < 0,10 dan hijab < 0,15. Seluruh angka merupakan target yang ditetapkan proyek, bukan hasil pengukuran.
Dua metrik toleransi aksesoris inilah yang paling bernilai praktis: mereka menetapkan toleransi degradasi per-aksesori, cara mengukur robustness yang jarang terlihat di implementasi serupa.
Penyimpanan Vektor dan Privasi Data
- Tabel vektor (pgvector):
national_id_hash, embedding (vector(512)), model_version, updated_at. Kunci pencarian adalah hash identitas, bukan citra. - Tabel metadata terpisah untuk laporan dan penghapusan, menyimpan ciphertext identitas nasional (AES-256-GCM dengan kunci terpisah, kuncinya salted-hash), model version, dimensi, dan path foto referensi.
- Hak penghapusan: soft-delete per-identitas, purge terjadwal setelah tenggang 30 hari; retensi audit 730 hari dan statistik 398 hari, keduanya dikonfigurasi.
- Logging terstruktur hanya memuat request ID dan hash — tidak ada PII di log.
Keputusan yang patut dicatat: foto referensi dipertahankan di disk (diperlukan agar hasil 1:N dapat menampilkan wajah yang cocok), namun basis data hanya menyimpan path dan hash — dan seluruh rantai itu terikat pada mekanisme erasure yang teraudit.
Pembahasan
Tiga pola desain dalam implementasi ini layak digeneralisasi. Pertama, pemisahan ambang dari skor: skor kemiripan tetap murni sebagai output, sedangkan keputusan match digeser ke ambang adaptif yang responsif terhadap kualitas citra — respons yang memuat semua komponennya (skor, ambang akhir, diagnosis kualitas) sehingga keputusan dapat diaudit pasca-facto. Kedua, versioning model per-vektor: satu kolom model_version mengubah pergantian model dari kejadian yang berbahaya menjadi operasi yang terdokumentasi. Ketiga, fail-closed pada deteksi: tidak terdeteksi wajah sama perlakuannya dengan spoof, bukan dengan lolos — default yang benar untuk sistem yang keputusannya bersifat konsekuensi.
Keterbatasan yang harus dinyatakan: tidak ada pengukuran akurasi (FAR/FRR, HTER, AUC) yang dihasilkan proyek ini; angka pada bagian fine-tuning adalah target evaluasi, bukan hasil. Perbandingan antar-model dalam artikel ini dibatasi pada kapasitas arsitektur (jumlah parameter, jumlah blok, konfigurasi) yang dapat dihitung dari definisi layer — keunggulan akurasi tidak dapat diklaim tanpa benchmark pada dataset uji yang sama. Mekanisme anti-spoofing mengandalkan klasifikasi pasif dari citra tunggal — bukan liveness aktif (blink challenge, 3D depth, texture analysis), sehingga serangan print/replay screen lebih mudah ditangani daripada deep-synthesized face. Ambang adaptif memakai heuristik bertier yang diset manual, bukan kalibrasi statistik dari distribusi skor empiris; dan kedua backend model menghasilkan ruang embedding yang tidak kompatibel, sehingga koleksi 1:N harus homogen per-backend.
Opini: Pola yang paling transferable dari implementasi ini bukan modelnya — melainkan disiplin metrik-nya. Menetapkan margin skor antar-kelas, toleransi degradasi per-aksesori, dan top-k recall sebagai angka target sebelum mengumpulkan data mengubah fine-tuning dari eksperimen menjadi kontrak. Bagi siapa pun yang membangun sistem biometrik di Indonesia, angka-angka tersebut (plus toleransi hijab < 0.15) seharusnya menjadi baris pertama di PRD — karena regulator dan pengguna akhir akan bertanya tepat di sana.